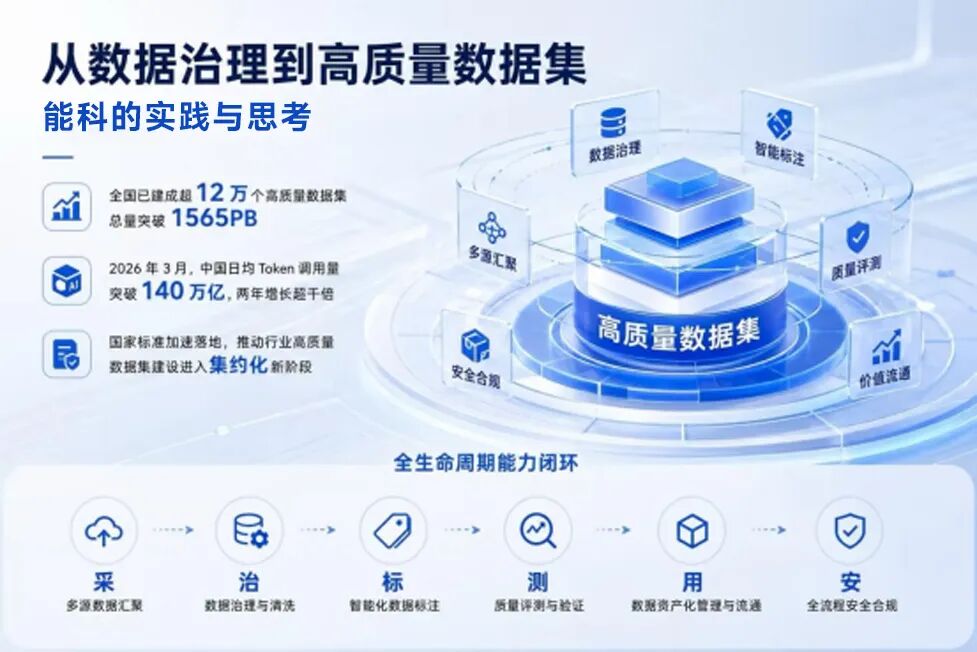
全国已建成超12万个高质量数据集、总量突破1565PB。
2026年3月,中国日均Token调用量突破140万亿,两年增长超千倍。摩根大通预测,2025至2030年中国Token消耗量年复合增长率将达330%。AI正在变成像水和电一样的基础设施。
但数据供给端明显跟不上。
国内中文开源数据集数量仅为英文的11%;85%的数据交易所挂牌数据集”有货无市”;对多数实体企业来说,数据还散落在PDM、ERP、MES、QMS等十几套业务系统里,编码不统一、口径不一致——连凑齐一条完整的业务链路数据,都要耗费数周人力对齐。
一边是AI算力渴求数据燃料,一边是高质量数据供给严重不足。这中间的鸿沟,正在成为企业落地AI的真正瓶颈。
01
为什么”高质量数据集”成了必答题?
先看三组关键信号。
需求端在爆发。
截至2026年6月底,全国已建成高质量数据集超12万个,总体量突破1565PB,半年增长超60%。但供给结构严重失衡——通用数据过剩,行业专识数据稀缺。19个重点领域加上低空经济、具身智能、智能驾驶等5个创新领域,每个方向都在喊”缺数据”。
政策端在加速。
2026年被国家数据局定位为”数据价值释放年”。年初宣布年内推出30余项数据领域国家标准,4月集中发布22项征求意见稿,第一次给”高质量数据集”下了权威定义并配套完整评测规范。6月印发《推进行业高质量数据集建设行动的实施方案》——这是国家层面首次对数据赋能AI作出系统性部署,六大专项行动从扩容、标注、提质、赋能、管理到价值释放,形成完整链条。72家链主单位签署任务书,行业建设从分散探索正式进入集约化推进阶段。
评测标准在落地。
2026年7月,国家数据局局长刘烈宏在全球数字经济大会上提出三大理念转变:从重格式统一走向语义贯通,从静态对齐走向动态适配,从分类施策走向国家标准。同时宣布加快出台高质量数据集格式要求、质量评测、数据标注等国家标准。
一句话总结:行业的底层逻辑变了——从”有数据就行”,转向”按标准生产数据、按质量评估数据”。
02
高质量数据集到底是什么?怎么评?
根据国标征求意见稿,高质量数据集的官方定义是:经过采集、加工等数据处理,可直接用于开发和训练人工智能模型,能有效提升模型性能的数据的集合。
三个关键词:经过处理、可直接用于、能有效提升。
原始数据不能直接喂给模型,就像原油不能直接灌进油箱。中间需要经过采集、清洗、标注、质检、评测等多道工序。
评测框架:三维度,均≥90分才算合格
国家数据局指导全国数标委研制的《高质量数据集质量评测规范》,构建了三维度百分制评测体系,三个维度均须达到90分及以上方可认定为”高质量数据集”。
维度一
说明文档——数据集不能是”黑箱”。
从基本信息(名称、版本、规模)、内容特征(数据类型、覆盖范围)、建设过程(采集方法、加工流程、标注规范、质控措施)到应用说明(适用场景、使用限制、已知局限),需要完整透明、可追溯。它相当于数据集的”数据护照”。
维度二
数据质量——八个硬性指标。
格式规范性、安全规范性、标注规范性、结构完整性、内容真实性、内容一致性、类型一致性、内容干净性。每一项都有可量化、可检测的细项标准。
维度三
模型应用——数据好不好,最终模型说了算。
聚焦实用价值,要求通过实证测试证明数据集对模型性能有实际提升,形成”模型验证驱动迭代”的闭环。
认证流程分四阶段:申请 → 初评 → 复评 → 认证。
目前全国数标委已研制70余种自动化测评算法,国家数据集管理服务系统已认证供需主体578家,上架数据集1433个。
这套标准传递的信号很明确:数据质量不再是模糊描述,而是可以量化、可以追溯、可以认证的。
03
能科乐数如何帮企业建高质量数据集?
我们的判断:数据中台需要往前走一步
过去数据中台主要做治理——把不同系统、不同格式的数据洗干净、理清楚、管起来。这是基本功,不能少。
但在高质量数据集的新要求下,光做”清洁工”不够了。企业面临的新问题是:仓库里清洗好的数据,能不能进一步加工成面向AI应用的、可认证、可流通的数据资产?
数据中台需要从”数据治理工具”往”数据资产运营平台”走一步。这不是概念升级,而是能力重构。
全生命周期能力
“采—治—标—测—用—安”
乐数数据中台围绕高质量数据集建设的全生命周期,搭建了六个环节的闭环能力:
多源数据汇聚——让数据”出得来”。
企业数据散落在PDM、ERP、MES、QMS等十几套系统中,格式不同、协议不同、编码不同。乐数支持ETL抽取、实时同步、API对接等多种接入方式,已实现核心业务系统的预置对接。从”数据在哪”到”数据可用”,汇聚时间从数周压缩至数天。
数据治理与清洗——让数据”对得上”。
这是乐数长期深耕的基本盘,核心能力包括:
主数据管理(MDM)
物料、BOM、工艺路线等核心主数据的统一管理,确保跨系统”同一个物料、同一个编码”。
数据质量管理
质量规则引擎+自动校验,覆盖完整性、准确性、一致性,问题数据自动标记、自动流转。
元数据管理
数据字典、血缘关系、影响分析,让每一行数据”从哪里来、经过什么处理、被谁使用”一目了然。
数据安全管理
分级分类、脱敏、细粒度权限控制,确保数据”该用的用得着,该保的保得住”。
智能化数据标注——让数据”学得会”。
数据标注是高质量数据集建设中最耗人力的环节。乐数支持从传统人工标注到”模型预标注+人工校准”的升级,覆盖图像、文本、语音、视频等单模态与多模态数据。
标注体系分三个层次:基础标注(通用场景)→ 进阶标注(行业场景)→ 专家标注(高专业壁垒场景)。采用”机器初步标注 + 人工校验 + 主动学习迭代”的流程,在保障专业质量的前提下,标注效率提升数倍。这与国家方案中”推动以人为主向人机协同、专家深度参与转型”的方向完全一致。
质量评测与验证——让数据”测得准”。
对标三维度评测规范,构建了200余项评测细项,通过”探针自测 + 程序评测 + 人工检测”三重机制逐项核验。模型应用层面,建立以模型性能反验数据质量的闭环——一个数据集好不好,不仅要看它通过了多少质检项,更要看它实际提升了模型多少性能。
数据资产化管理与流通——让数据”流得动”。
将高质量数据集纳入企业数据资产目录,支持版本管理、血缘追踪、数据服务API化和资产化运营。
全流程安全合规——让数据”用得安”。
安全是底线。包括数据脱敏、基于角色的细粒度权限管控、合规保障,以及通过隐私计算、联邦学习实现的”可用不可见”——数据不出去,价值出去。
我们的方法论
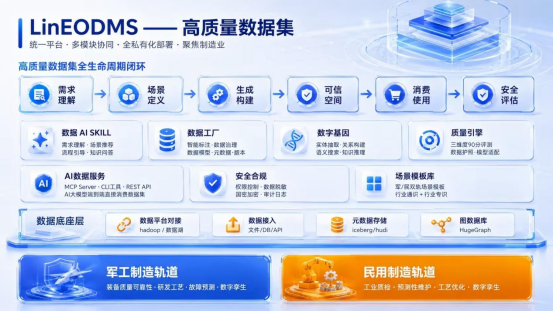
能力是工具,方法论是怎么用好这些工具。在实践中我们形成了五个原则:
需求导向
不以”有什么数据”为起点,而以”模型需要什么”为起点,倒推数据维度和质量标准
源头控制
从数据产生的环节就把住质量关——设备规范化、流程可审计
流程化质量管控
不是手工作坊式地”标一批算一批”,而是建立标准化生产流程,”模型预标注+人工校准”形成可持续产能
全生命周期管理
制度构建、目录管理、发布管理、质量监控、更新管理,贯穿始终
场景闭环
以场景定数据、以数据促模型、以模型赋能应用,形成数据飞轮
04
落地实践,某高端装备研制企业数据集建设
高质量数据集不能只停留在标准层面,必须落地垂直行业场景。依托乐数全链路能力,我们助力某高端装备研制企业搭建装备全生命周期专识数据集,项目成果对标国资委”百域智数”高质量数据集建设要求,入选央企行业高质量数据集优秀成果。
项目背景
该高端装备研制企业的研发、工艺、生产、试验数据分散于多套异构系统,数据标准不统一、专业标注体系缺失,核心数据安全合规要求严苛。存量数据无法直接支撑AI训练与智能应用落地。
项目成效
建成高端装备领域专识高质量数据集,数据规模达TB级别,覆盖研发设计、工艺规划、生产制造、试验验证全链路,三个维度质量评分均≥90分,入选国资委”百域智数”央企高质量数据集优秀成果。
基于该数据集训练的智能分析模型已在故障预测、工艺优化等场景落地。同时沉淀形成一套可复制的高端装备行业数据集建设与合规运维方案。
05
为什么是乐数?
市面上做数据的公司不少。做好高质量数据集,需要三方面能力凑齐:懂治理、懂行业、懂AI。
懂治理。乐数数据中台不是从零起步。在数据治理领域已沉淀了数据集成、主数据管理、数据质量管理、元数据管理、数据标准管理、数据服务、数据安全管理等核心模块,经历过大型企业复杂数据环境的实战检验。治理是高质量数据集的底盘——底盘的扎实程度,决定了上层能建多高。
懂行业。高质量数据集不是通用数据的简单堆砌。工业制造的数据标注需要懂工艺流程,重工装备领域的数据处理需要懂保密要求。国家方案明确的19个重点领域和5个创新领域,每个都有自己独特的数据特征。乐数的团队里,有数据工程师,也有行业专家——没有行业知识的数据团队,做不出真正能用的行业数据集。
懂AI。我们理解”模型验证驱动迭代”的思路——数据好不好,最终看模型效果。多模态数据集、具身智能数据、合成数据、思维链标注,这些方向我们都在关注和布局。数据集的终极裁判不是质检报告,而是模型性能。
06
你的数据距离”国标90分”
还有多远?
高质量数据集建设是长期的事。
首先是需要政策牵引——国家已经给了方向和标准,30余项国标正在路上。然后是需要技术工具——从采集到评测,每个环节都不能缺。同时也需要行业积累——没有对垂直领域的理解,数据就只是量而非质。从顶层看是需要体系化的方法论——贯穿需求、采集、治理、标注、评测、应用全生命周期。
乐数在这条路上走了不短的时间,有一些积累,也有一些思考。从数据治理到数据资产运营,从传统数据仓库到面向AI的高质量数据集,我们和客户一起在迭代。
| 文章作者:贺小川
| 排版执行:孙凯丽