摘要:
随着可持续交通解决方案和可再生能源存储系统需求不断增长,提高了对电池热性能进行精确有效预测的必要性。然而,实现精度和效率都是一个挑战,需要探索不同的方法。传统的计算流体动力学 (CFD) 的使用可以全面了解热动力学,但通常优先考虑精确性而非效率。为了提高这种传统方法的效率,出现了许多降阶建模技术,机器学习(ML)的概念为增强仿真能力提供了一种独特途径。
本文提出了一种通过集成CFD和ML来加速电池热分析的新方法。CFD模拟提供了对电池内部热动力学的复杂理解,包括流体流动和温度分布。在这种物理理解的基础上,ML模型使用CFD数据进行训练,以捕获热行为中的复杂关系和模式,从而开发出能够有效预测不同操作条件下热响应的框架。
为了验证所提出方法的有效性,本文提出了一个案例研究,将ML方法的结果与CFD 结果进行了比较。研究结果表明,所提出的方法显著减少了计算时间,同时在预测电池热行为方面保持了相当高的准确性。这种创新的方法有效促进了电池系统设计和优化,有助于进一步缩短可持续能源技术的开发周期。
介绍:
对于电池包来说,温度对电池的性能、储能能力、寿命和可靠性起着至关重要的作用。从安全角度来看,温度上升超过临界阈值会导致热失控等不良现象。这就需要对电池系统关键区域的温度变化进行准确的预测。在传统的预测分析方法中,如流体力学(CFD)、第一性原理模型方法、基于测试的分析等,针对不同的环境,不同的需求提供了解决方案。CFD解决方案可以详细了解电池组内部的热动态,包括电池单元的温度、冷却剂的温度以及电池组的空间温度变化。系统分析模型可深入了解电池温度对电动汽车中电机、车辆等下游组件的能量转换效率、储能能力和性能的影响。计算分析的进步带来了不同方法的发展,如联合仿真、功能模型交换(FMU),将这些仿真环境结合在一起。然而,这些方法并没有解决对提高计算效率的需求。
随着机器学习的最新进展,工业解决方案的科学研究及适应性已经越来越广泛。这些技术在主流产品开发中得到适应性的应用,因为它们提供了一个框架,将仿真环境引入并结合在一起,充分利用计算效率。
华晨宝马汽车有限公司(BMW Brilliance Automotive Ltd.)感兴趣的一个方向是开发代理模型,使他们能够更快地进行这些温度预测。与西门子合作的目标是根据CFD数据建立电池传感器网格模型,以捕获温度的在空间和时间上的变化。主要针对电池单元、冷却板和每个电池单元中的关键位置等,对电池模块的温度变化进行预测。
降阶模型(ROM)是一种简化模型,它在保留原始系统的基本行为的同时,通过数学抽象和探索法来降低其复杂性。近年来,由于大数据的可用性以及深度学习 (DL)模型和方法的稳定性和准确性,使用机器学习 (ML)技术开发精确的 ROM变得越来越流行。然而,选择正确的 ROM 技术取决于输入输出关系和输入数据格式的复杂性。有多种流行的神经网络(NN)架构, 包括多层感知器(MLP)、卷积神经网络(CNN)、循环神经网络(RNN)及其变体。每种架构都针对不同的应用和数据形态进行了优化。对于仿真应用,重点是开发适合的工作流程,以利用所有数据,并使用正确的架构和训练方法收敛到准确的模型。
技术方法、路线
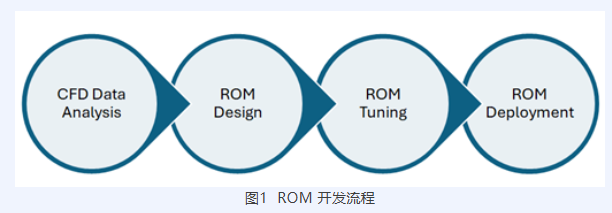
基于CFD 数据开发详细的ROM模型的工作流程如图1 所示。该工作流包括CFD 数据预处理和输入变量分析、模型架构选择、模型微调和数据覆盖敏感性分析,以及在仿真框架中部署模型。该工作流的目标是构建一个电池传感器网格模型,该模型可以准确预测重要电池模块之间如电池单元、冷却器板和每个电池单元中关键位置等温度的时间变化。
本文中用于训练 ROM的电池温度数据是使用业界领先的 CFD 求解器Simcenter Star-CCM+ (SC CCM)生成的。
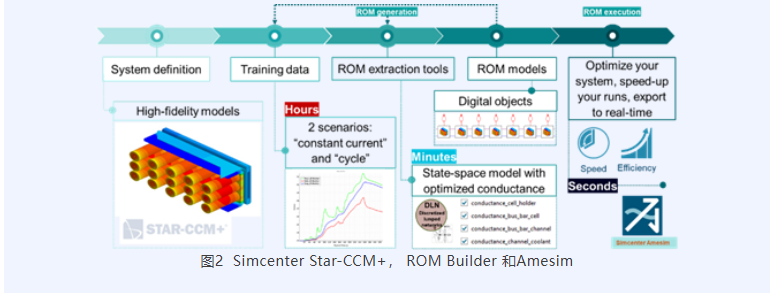
使用西门子的Simcenter ROM Builder(SC ROM)来开发和训练降阶模型。对于仿真用户来说,SC ROM 是一 个无代码工具,允许用户基于不同的数据源生成和输出降阶模型。
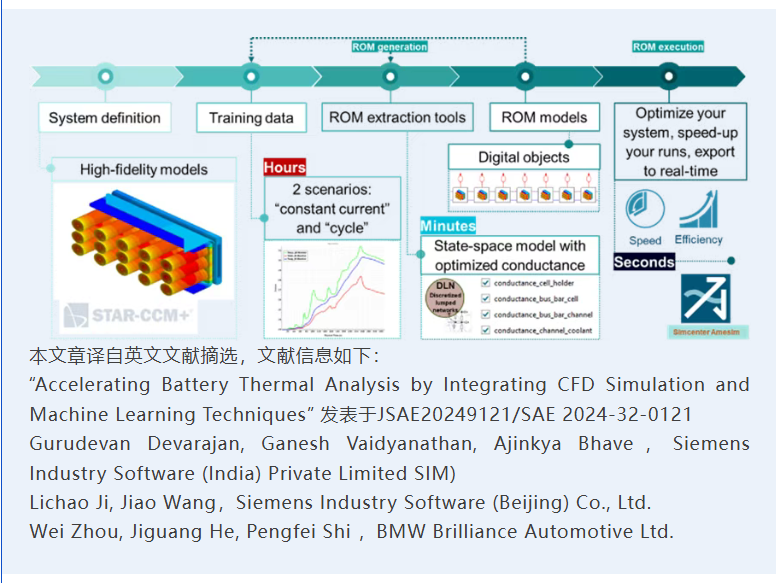
典型工程应用工作流程如图2 所示。
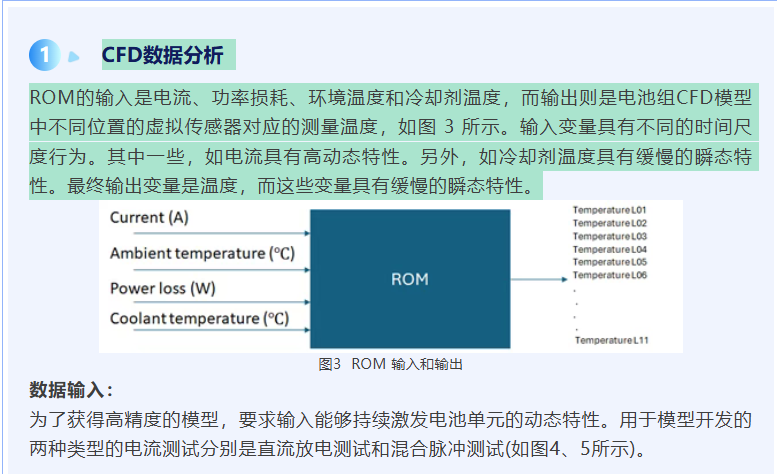
对于模型开发,提取了一组多个分析场景的 CFD分析结果,这些分析场景涵盖了电流负载、热负载和温度应力源(如环境温度和冷却剂温度)的变化。
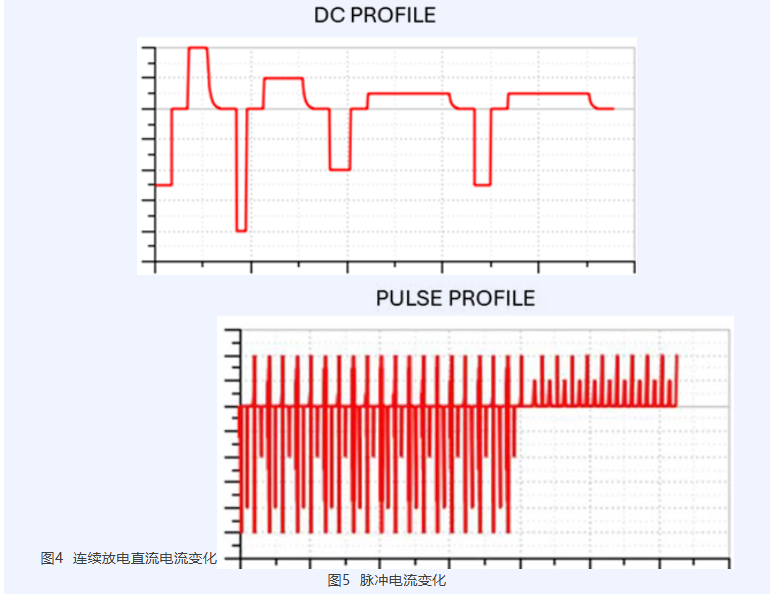
数据配置:在输入中,电流和功率损耗表现出瞬时变化,这意味着它们立即波动而没有任何滞后影响。这表明输入的数据不会对未来的行为产生影响;每个时刻的输入与之前发生的事情无关。
另一方面,冷却剂温度的变化遵循一个渐进的变化过程。 与电流和功率损失中看到的直接变化不同,冷却剂温度受其历史数据的影响。这意味着冷却剂温度的过去状态会影响其未来状态,从而产生随时间变化的累积响应。
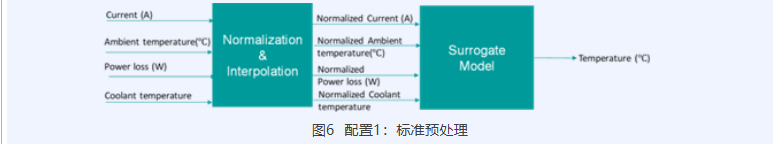
同样,所有的输出都是温度,并表现出具有历史效应的累积响应。 由于行为模式的不匹配,输入和输出之间的直接映射可能无法提供适当的代理模型。因此,通过对输入数据使用不同的预处理技术,针对几种模型配置进行研究。 在第一个配置中,如图 6 所示,输入和输出通过归一化进行预处理,以缩放其范围和插值,以允许不同的采样时间。除了这些标准的数据处理技术外,没有对信号进行进一步的修改。
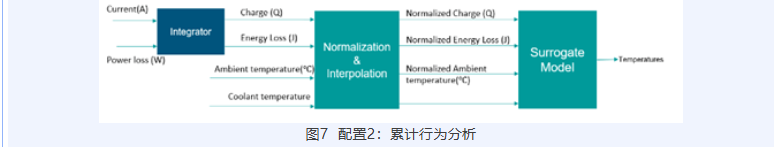
在第二种配置中,通过对输入进行积分并将积分值提供给模型作为输入,将输入的瞬时行为转换为累积行为。这如图 7 所示,其中电流被积分为充电,功率损失被转换为累积的能量,这是归一化和插值后模型的最终输入。
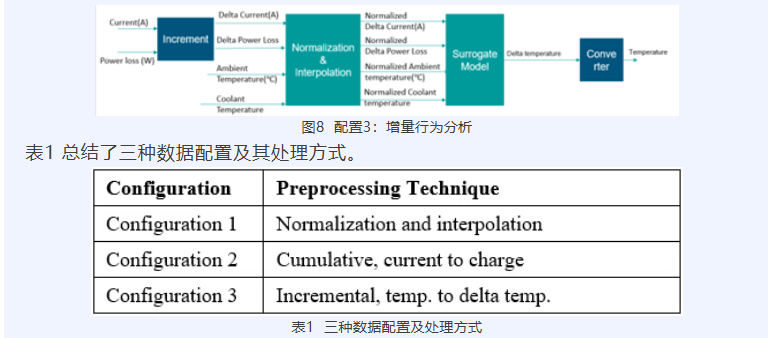
在第三种配置中,模型识别基于输入和输出的增量变化。变化的输入(电流/功率损耗)被转换为每个样本时间的增量,而不是绝对幅度。输出也以同样的方式转换为增量值。如图 8 所示,这种配置提供了一种将电流/功率损耗的变化映射到温度变化的方法。与前两种配置相比,这可能有助于模型更准确地学习微小的变化。输入必须转换为增量输入,预测输出必须再次从增量值转换为绝对值,然后才能进一步使用。
配置 1 和 2 也可以称为直接拟合方法,初始条件需要成为神经网络训练的一部分。因此,有时不太容易完全控制初始值,并且可能在运行开始时出现瞬态。
2. ROM设计
工作流的下一步是确定数据处理配置并定义基础的神经网络(NN)模型体系结构。与传统方法不同,在这项工作中,神经网络架构不是手工设计的。SC ROM工具能够针对采样时间、层类型、激活函数、优化器、学习率和超参数的变化执行模型搜索扫描。 对于扫描深度,模型搜索有两种模式:
a) 快速扫描提供了几个模型的快速计算,但覆盖的超参数数量很少。
b) 标准扫描涵盖了更多的超参数,但计算时间可能会很长。 由于模型搜索涵盖了网络架构和超参数的变化,因此在有限数量的数据集上评估数据配置性能以进行权衡分析。
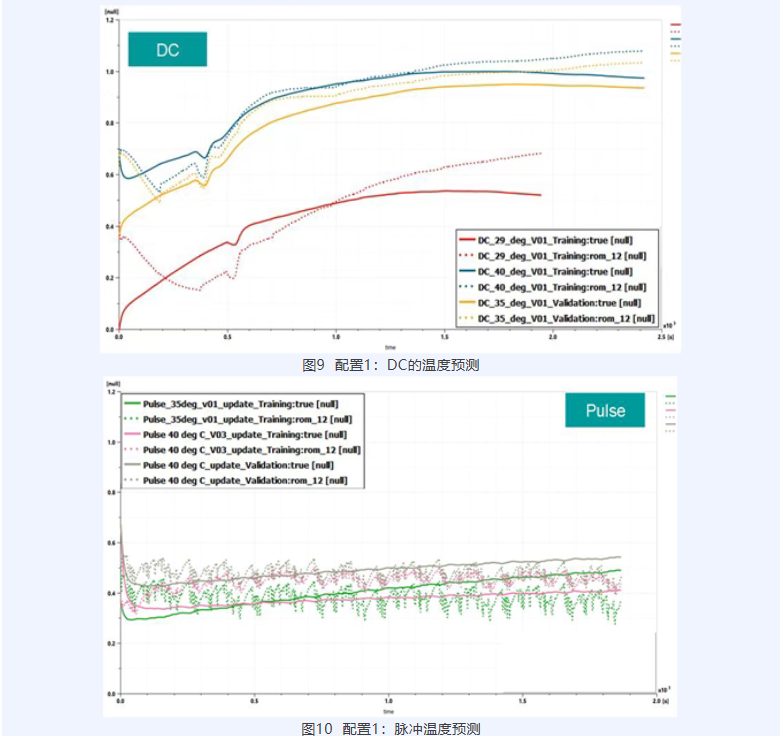
针对配置一,用三组数据比较了实际传感器数据和 ROM 模型温度的预测。图9显示了直流信号的比较,而图10显示了脉冲信号的比较。可以观察到,代理模型无法准确预测传感器温升。
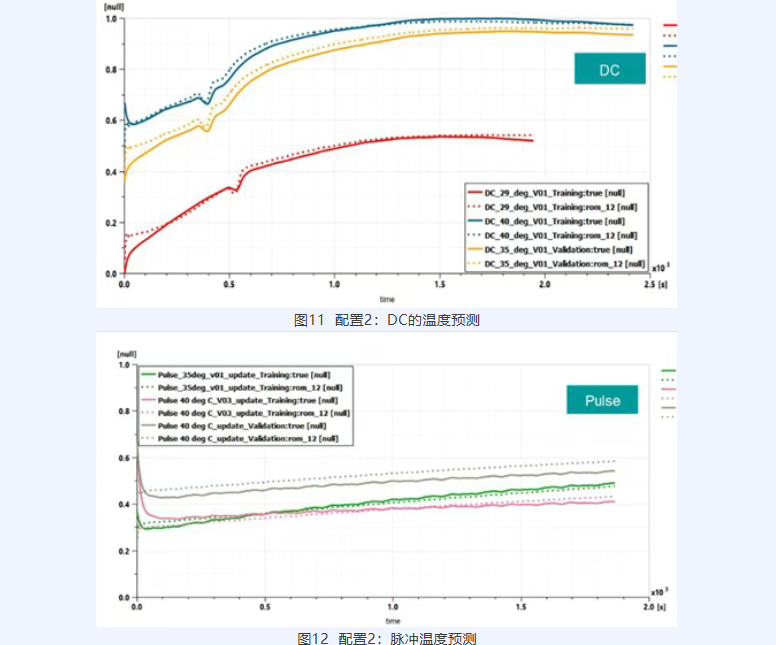
针对配置二,用三组数据比较了实际传感器数据和 ROM 模型温度的预测。图11 显示了直流信号的比较,而图12 显示了脉冲信号的比较。可以观察到,代理模型很好地捕获了温度的累积行为。通过微调 NN 架构和添加平衡的训练数据,改善了未准确预测的输出波动。
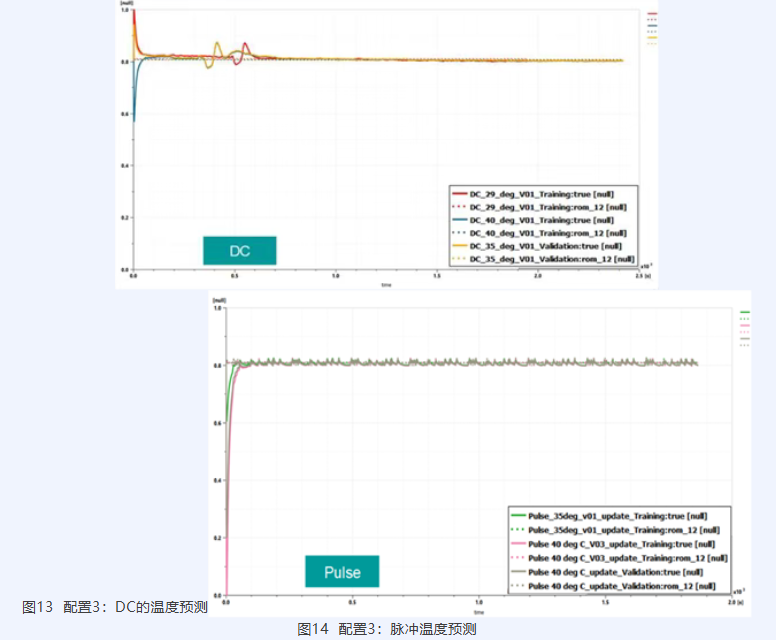
针对配置三,用三组数据比较了实际传感器数据和 ROM 模型对温度的预测。图13 显示了直流信号的比较,而图14 显示了脉冲信号的比较。可以观察到,代理模型不能很好地捕捉温度的增量上升,并且与传感器数据存在显著偏差。
基础模型在三种数据配置上的最终预测精度汇总见表 2。基于该项研究,我们选择配置 2 作为工作流后续步骤的数据映射。
3.ROM调试
一旦定义了数据配置和初始 ROM,我们必须以客观的方式确定如何将数据最优地分为训练组和验证组,以避免模型的欠拟合或过拟合。
数据集设计
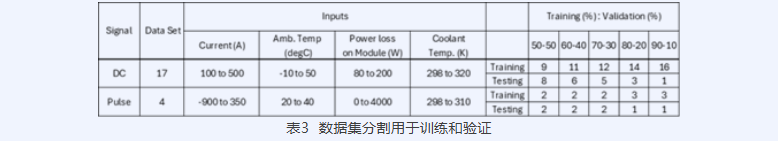
总共使用了多个数据集,由直流和脉冲信号混合组成。 根据不同的分割百分比,定义用于训练和验证的数据集数量,如表 3 所示。所示的电流、环境温度、模块上的功率损耗和冷却剂温度的输入范围是用于训练和测试模型的实际值的近似表示。在训练和测试 ROM 时,将直流数据集和脉冲数据集结合使用。例如,对于 60-40 分割,使用13 个用于训练的数据集和8个用于测试的数据集。
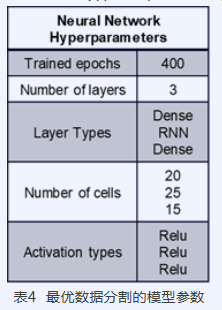
对于训练数据和验证数据的不同分割,用于模型保真度 的收敛 NN 模型架构如表4 所示。它由 NN 模型设计中使用的典型超参数组成,包括层数及其类型。如表4所示
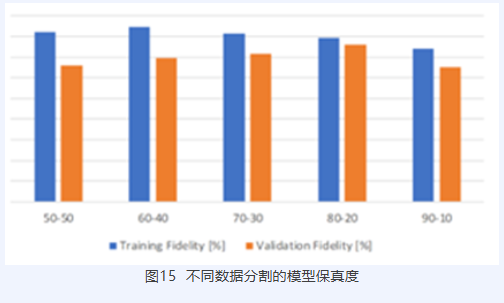
从图15中可以看出,尽管60-40分割的训练精度似乎更高,但我们还是选择了80-20分割作为进一步分析的最佳选择。这是因为对于80-20分割,训练精度和验证精度之间的差异得到了更好的平衡,这表明对训练数据的过拟合较少。
敏感性分析
在这个阶段,基线模型结构、数据映射配置和最优数据分割已经客观定义。工作流程的下一步是基于灵敏度分 析对ROM 架构和超参数进行微调。
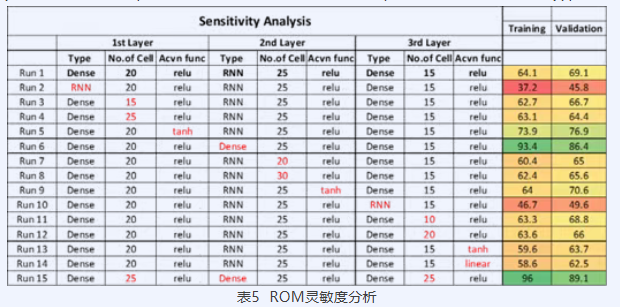
在此分析中,评估输入变量的变化对模型或系统的预测 输出的影响,目标是了解模型或系统对不同因素的变化有多敏感。这种分析有助于识别超参数的临界值。在这种情况下,通过改变特定的超参数来完成实验设计,以了解每个参数对模型性能的孤立影响。在 ROM 中,有几个参数可以提高模型的精度。通过调整层类型、层数、每层细胞数、激活函数类型等超参数,对模型架构进行了细化。理论上,优化架构有很多可能性,但由于时间和计算预算的限制,这是不现实的。在本研究中,我们基于上一步使用该配置获得的令人满意 的精度,将模型搜索空间限制在三层,并研究了其他超参数的影响。
灵敏度分析结果汇总于表5。分析显示了当模型训练400 次时,不同网络架构的训练和验证精度。对于温度预测的目标,我们观察到以下趋势:
a) 使用Dense 层代替RNN 层可以获得更好的精度。
b) 使用 Relu 作为激活函数比使用tanh效果更好。
c) 将所有层的单元格数量增加到一定数量可以提高精度,而不会导致过度拟合。
4.ROM部署
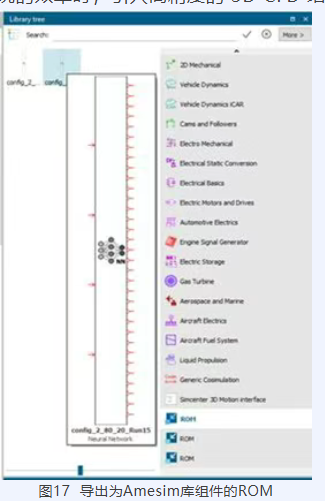
ROM的训练和随后的验证时针对电池模块内33个位置的温度和两种不同的电流曲线(直流曲线和脉冲曲线)进行的。ROM模型的运行时间约为40ms,在相同场景和相似的温度预测精度下,这比CFD 模型的运行时间快了约55,000 倍。这意味着ROM 可以作为详细的 CFD 电池组模型的替代方案,用于快速设计空间探索,灵敏度分析,电池组设计更改以及与CFD 模型的更高精度相比,ROM 的速度和灵活性具有优势的类似应用。为了 实现这一要求,需要根据BBA的仿真环境和工作流程将 ROM 转换为正确的格式。SC ROM 工具支持以四种格式 导出训练模型:
a) Simcenter Amesim 子模型
b) FMU 2.0 模型
c) ONNX模型
d) MATLAB的S函数
ONNX导出
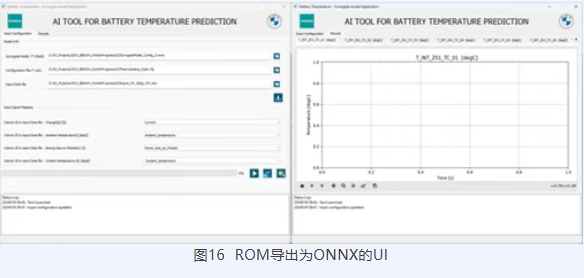
第一种方法是开发一个独立的免许可用户界面,使用 ONNX 模型来预测输入条件(如环境温度、冷却剂温度、 电流等)的温度变化。
用Python 开发的UI作为封装ONNX 模型的脚本,用于读取数据输入,运行训练神经网络模型并可视化并生成结果文件。
SC Amesim导出系统仿真
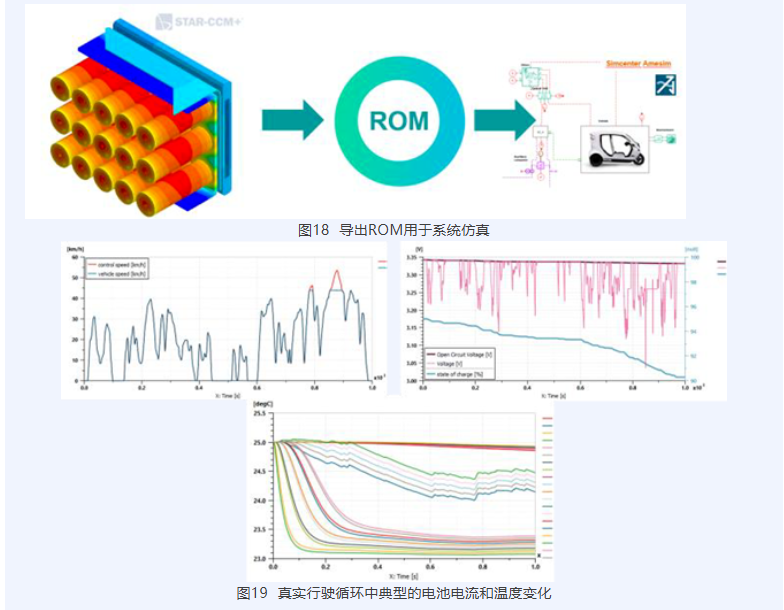
下一个需求是将代理模型导出到SC Amesim 环境。导出的电池热量降阶模型可以集成到具有所有子系统和真实驾驶循环的整车模型中。该方法作为一个桥梁,在探索更大的系统并随后评估热管理系统的效率时,引入高精度的 3D CFD 结果。
物联网/xDT部署
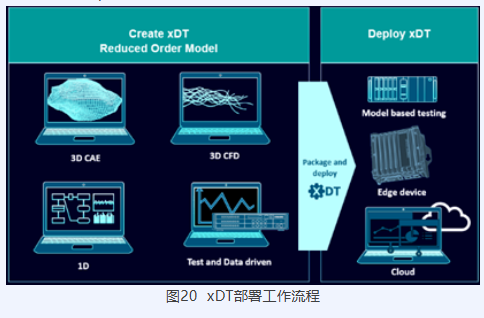
ROM 是基于矩阵的模型,具有优化的计算需求。在这种情况下,电池热 ROM 的运行时间为 40 毫秒,大约比CFD 模型的运行时间快55,000 倍。这也使它们能够用于物联网(IoT)和可执行数字孪生(xDT)应用程序。因此,它们可以部署在便携设备上,也可以部署在 web 应用程序中,用于虚拟传感、模型预测控制和状态监测等用途。
自部署
下一个产品创新领域越来越依赖于受控机电一体化系统的引入。这意味着电子控制单元(ECU)的快速扩展及其在子系统内的完美集成,以提供正确的用户体验。工厂模型包括 ROM 模型及其执行器和传感器。它与控制策略相结合,首先作为软件组件(SiL),然后导出到 具有实时目标(HiL)的硬件,以一起运行控制和工厂模型。
结果
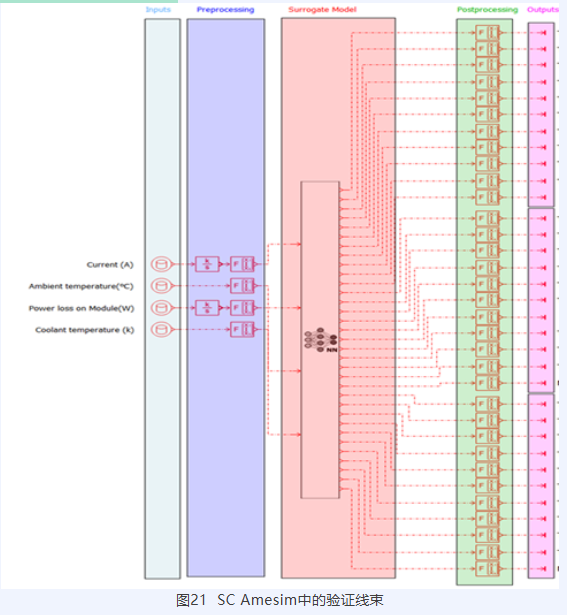
SC ROM 环境具有内置的可视化功能,用于评估训练数据集和验证数据集中的相关性程度。在 SC Amesim 中,跨不同数据集的多个输出的可视化要容易得多。 将ROM 模型导出到SC Amesim,并构建如图21 所示的验证工具。在此工具中,进行预处理以将输入数据转换为标准化格式,代理模型预测归一化温度,并进行后处理以将温度输出转换为非归一化格式。
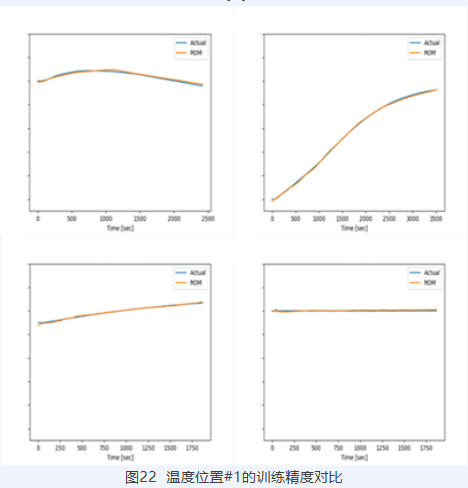
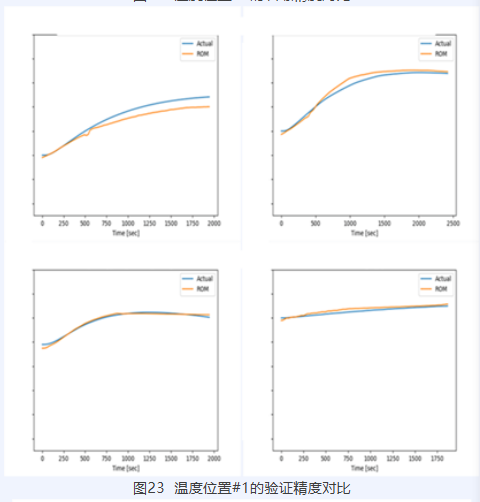
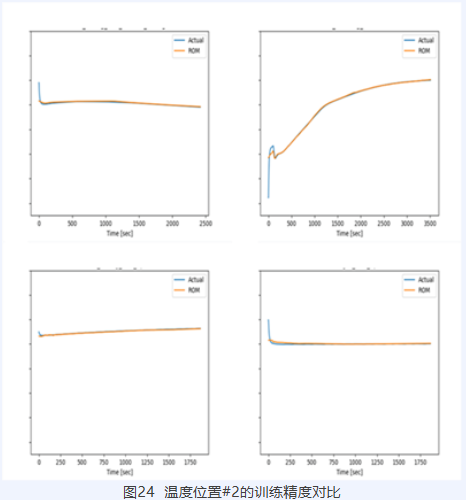
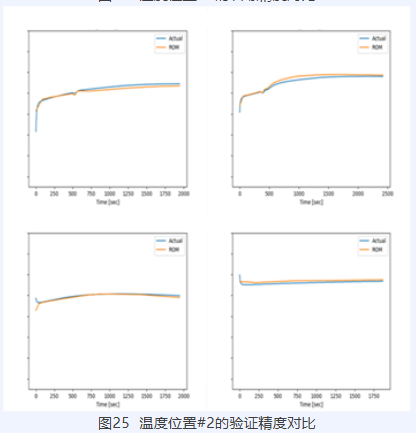
在两个不同的虚拟传感器位置以及直流和脉冲电流输入下,CFD 模型输出和 ROM 预测的温度比较如下图所示。#1位置的训练精度如图 22 所示,相应的验证精度如图
我们可以看到,ROM 可以预测两个不同测量位置的温度分布,与CFD 结果非常接近。尽管训练数据和验证数据之间的温度曲线差异很大,但该模型预测时间变化的精度很高。这表明 ROM 没有过拟合,可以用于用于模 型训练的数据边界之外的其他操作条件。
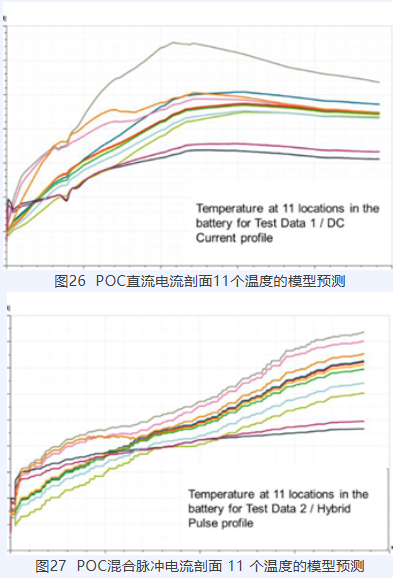
此外,为了增强模型的可扩展性和鲁棒性,我们使用了两个未包含在训练和验证数据集的额外的测试数据来评估其行为。具体来说,一个测试数据涉及直流电场景,而另一个涉及混合脉冲场景。该评估旨在确定ROM模型在开发阶段未遇到过运行工况下的性能 。
5.结论
本文演示了一种基于机器学习的 ROM,用于预测电池系统内部温度的时间变化。在 SC Star-CCM+ CFD 求解器中运行多个快速充电场景后,根据SC ROM 中的模拟结果训练神经网络模型,以重现电池组的热行为。该 ML 模型以非常高的精度再现了电池组的所有热特性, 并提供了令人印象深刻的 40 毫秒运行时间,比CFD求解器快 55,000 倍。该模型可以插入等效的电路模型中进行系统分析,无论是模型在环(MiL)还是软件在环 (SiL),都可以进行电池安全性,性能和寿命的合规性分析。
如果想了解更多,欢迎联系我们!
申请免费试用:
如您对 Simcenter 及系列软件及解决方案感兴趣,欢迎联系我们
#CFD流体动力学仿真分析
#多物理场仿真/仿真集成平台