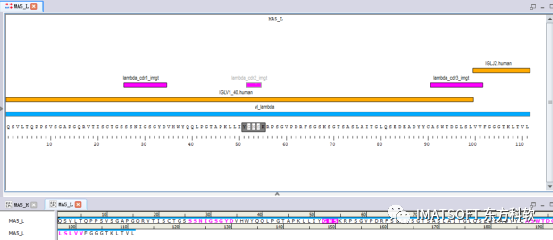
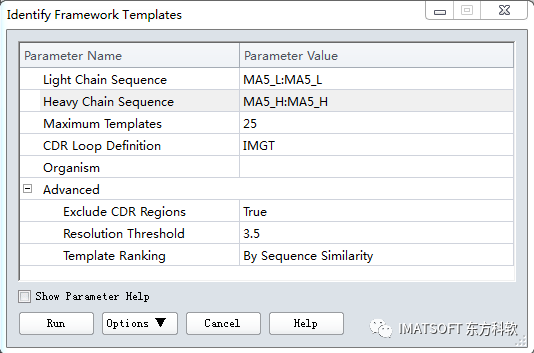
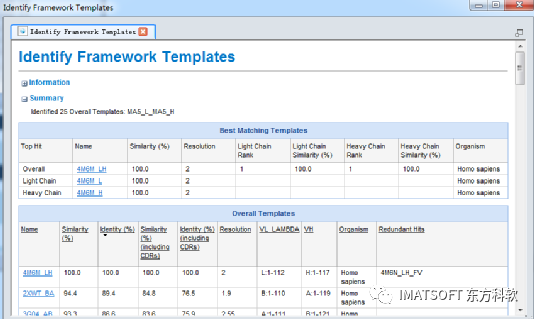
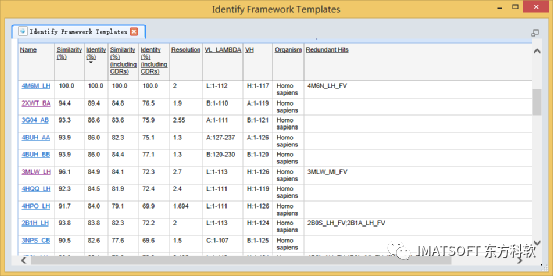
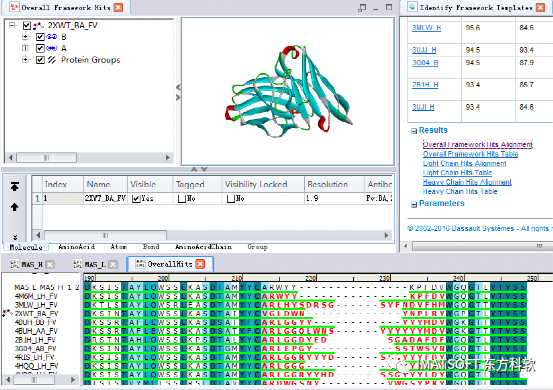
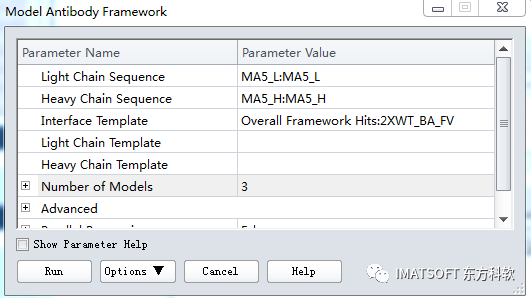
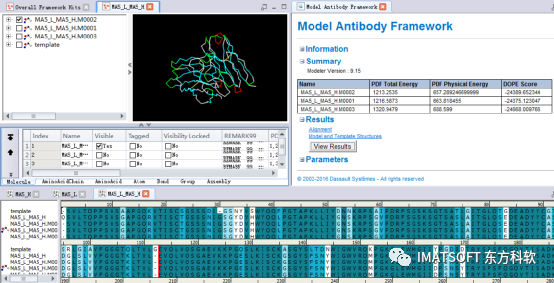
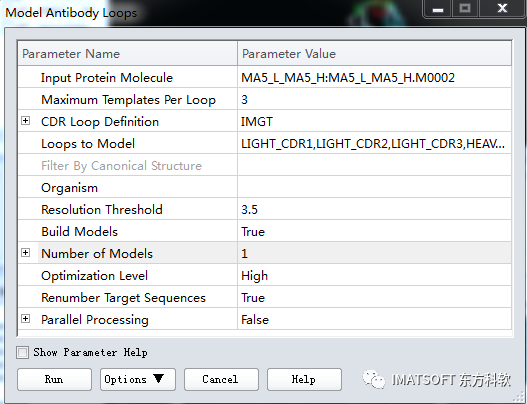
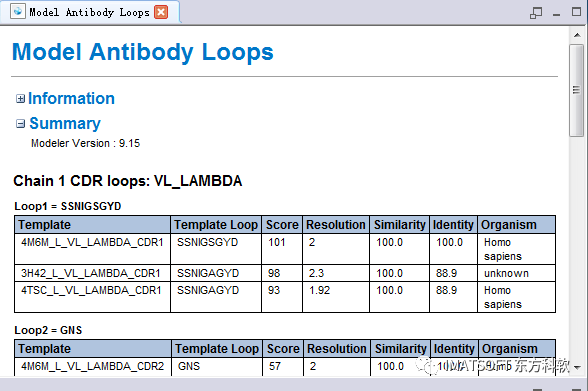
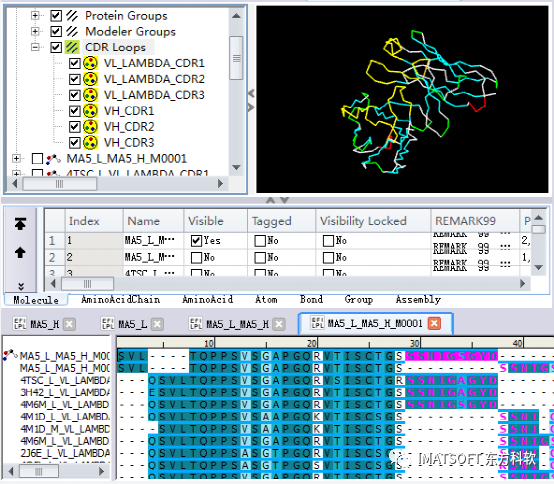
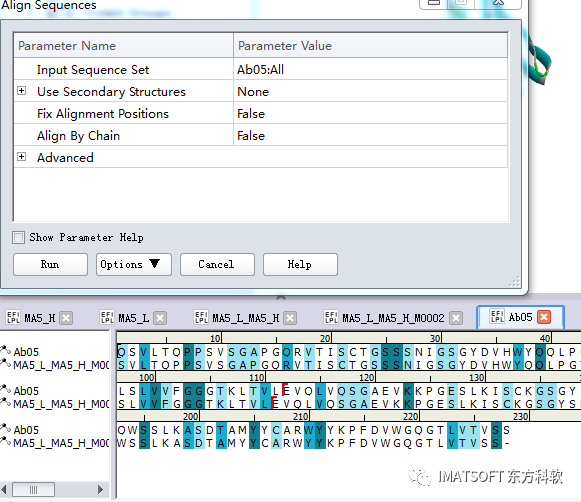
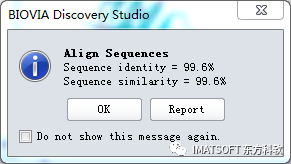
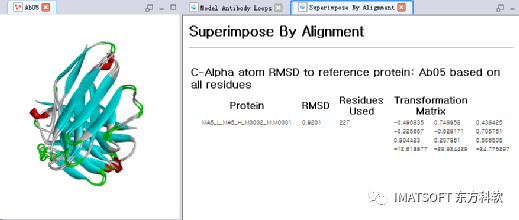
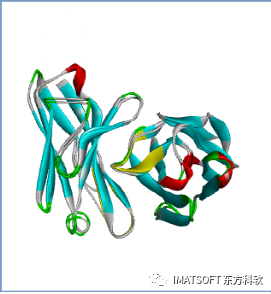
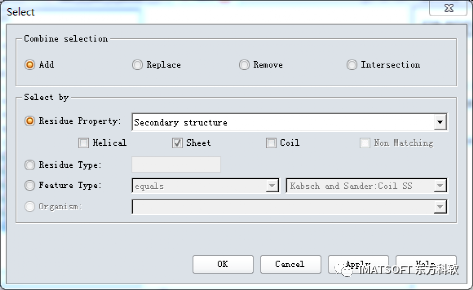
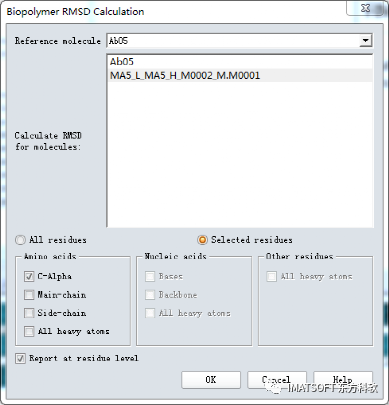
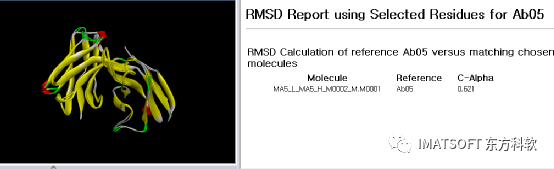
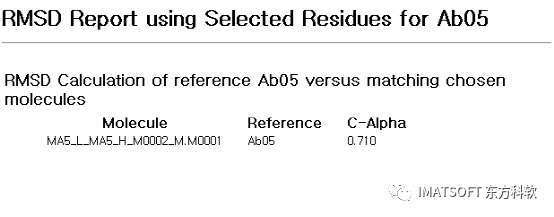
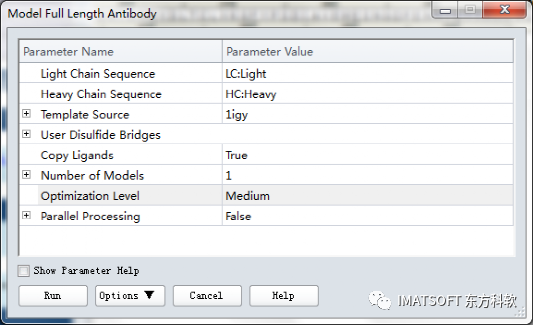
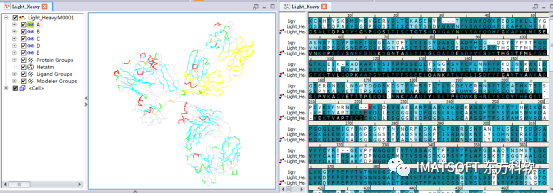
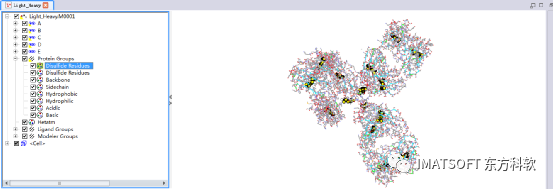
当前位置: 软服之家 > 解决方案 > 东方科软(北京)科技有限公司 > Discovery Studio官方教程(Help-Tutorials) 基于MODELER构建抗体模型 Discovery Studio官方教程(Help-Tutorials) 基于MODELER构建抗体模型 [ 解决方案 ] 东方科软 2023-06-15 16:58 #生物/化学/分子仿真分析 目的: 通过此教程,了解Discovery Studio中基于抗体序列构建抗体全长及Framwork区模型的操作方法及结果分析。 所需功能和模块:Discovery Studio Client,DS Sequence Analysis,DS MODELER,DS Protein Families,DS Validate Protein Structure。 所需数据文件:MA5_H.bsml、MA5_L.bsml 所需时间:1小时 介绍 抗体分子是生物学和医学领域用途最为广泛的蛋白分子。以肿瘤特异性抗原或肿瘤相关性抗原、抗原独特型决定簇、细胞因子及其受体、激素及一些癌基因产物作为靶分子,利用传统的免疫方法或通过细胞工程、基因工程等技术制备的多克隆抗体、单克隆抗体、基因工程抗体广泛应用于疾病诊断、治疗及科学研究等领域,并以其毒副作用小、天然和高度特异性的疗效,创造出了巨大的社会效益和经济效益。 抗体和抗体-抗原复合物的结构通常被用于了解基于抗体的药物的作用机制,在抗体工程上提供帮助。X射线晶体学方法有助于抗体结构的解析,但是与计算模拟相比,耗费的经济成本和时间成本太高。 本教程中使用DS基于一个合成人类Fv区域的序列构建3D抗体模型,相对于X射线晶体结构选择性评估模型的质量。随着大量的抗体Fv区域、Fab区域和高度保守区的结构被解析出来,使用同源模建的方法构建抗体结构成为可能。构建一个抗体Fv或Fab区域结构模型的一个典型的流程是首先根据已知抗体模板结构构建框架结构,然后必要的时候使用额外的模板优化互补决定区。在本教程中的任务包括以下几个步骤: 结构模板的识别 抗体Framework区模型的构建 构建抗体Loop区 模型可靠性的评估 抗体序列的分析和识别 载入序列。在本教程中对于序列的分析这一步对于构建抗体结构不是必须的,但是对于序列的分析有助于了解你即将构建的抗体模型的结构成分。Annotate Antibody Sequence protocol可使用一些预处理后的隐马尔科夫模型对抗体序列中的结构域和CDR区进行识别和注释。 在文件浏览器(Files Explorer)中,展开Sample| Tutorials| Protein Modeling,双击打开MA5_H.bsml、MA5_L.bsml文件。关闭DS欢迎页面,选择MA5_L Sequence Window,打开Macromolecules | Model Antibody工具面板, 鼠标左键点击Annotate Antibody Sequence.确保 Input Sequences设置为MA5_L:All,其他参数使用默认,点击Run等待任务完成。 上述两个序列依次分别为抗体MA5的重链(H)序列和轻链(L)序列。 计算完成之后会自动打开一个序列注释结果窗口(如上图),蓝色的表示轻链可变区,粉红色的表示CDR loop区,同样的结构域在序列注释窗口显示同样的颜色。如果你在序列注释窗口中选择一段loop区,相应的氨基酸会在下方的序列窗口中以同样的颜色显示出来。 小技巧:鼠标右键点击序列窗口的标尺工具可以选择Residue ID,显示出每个氨基酸的残基号。 同理,可以用同样的方法把重链的序列分析注释显示出来。 Framework区模板的识别 在工具浏览器(Tools Explorer)中, 展开 Macromolecules | Model Antibody,点击打开 Identify Framewwork Templates。 设置Light Chain Sequence为MA5_L:MA5_L 设置HeavyChain Sequence为MA5_H:MA5_H 其它参数默认,点击Run运行(图1) 图1 作业大概需要一分钟的时间。待作业完成后,点击Report页面,查看Summary。报告的页面有四张表格,第一张表格是根据Similarity得到序列相似性最高的表面、轻链、重链模板,以下三张表格分别是搜索得到的所有的表面、轻链、重链模板。 抗体Framework区建模有两种方法:嵌合方式、单模板方式。嵌合方式能较全面的考虑轻链、重链模板的结构信息,同时根据表面模板决定轻链、重链的空间取向,但有时来自两条不同蛋白的轻链、重链模板与第三条表面模板叠合时,空间取向可能会不准确。无论嵌合方式或单模板方式建模,模型的质量都与搜索得到的表面模板或轻链模板、重链模板序列相似性有很大的关系,同时CDR区的的序列相似性对Framework区结构质量也起很大的作用。 本教程采用单模板方式进行抗体Framework区建模,点击Summary下第二张表格Overall Templates中的Identify(%)两次,使其按照Identify降序排列,点击第二个2XWT_BA,载入结构(图2)。 注意: 模板4M6M_LH是表中最匹配的模板,相似性和一致性都达到100%,这个模板就是本教程中的序列的晶体结构,为了后续的对比,我们在此不使用这个模板。 再次排序之后列表显示2XWT_BA的相似性达到94.4%,一致性达到89.4%,分辨率为1.9埃。如果你使用相似性排序,你会注意到2XWT仍然是比3MLW匹配度高。物种属性表明2XWT是一个人源抗体,对于合成的人类抗体序列是很合适作为模板的。你可以设置模板识别参数进行筛选,比如设置物种来源或NCBI taxomomy ID,或者更高分辨率的晶体结构。 抗体的最大的变化位于CDR区,在该区形成抗原结合位和明确抗体特异性。模板相似性和一致性的百分比,包括CDR区可以帮助你比较结果。 图2 在右边模板识别结果报告网页的最下面,点击Overall Framework Hits Alignment链接。如下图 点击后在序列窗口中自动打开了一个叠合好地序列窗口(如上图),比较2XWT和3MLW的H3 LOOP区(213-232号残基)可以发现前者在这一区域中的长度与目标序列更接近。 回到右边报告网页中的第二个列表中,点击3MLW_LH。 在同一个分子窗口中多出了一个3MLW的结构,我们可以看到最大的结构变化位于H3 LOOP区。基于模板的检查和晶体结构分辨率的比较,我们选择使用2XWT作为模板构建我们的抗体结构,它具有高度的序列相似性和一致性,相似的H3 LOOP区的长度和较高的分辨率。 关闭模板识别报告窗口,序列注释窗口和叠合序列窗口。 构建目标序列的3D模型 在本教程中,我们将使用Model Antibody Framework protocol构建抗体结构模型,这个protocol同样可以用于构建Fab 抗体。 1 构建模型 在工具浏览器(Tools Explorer)中,展开Macromolecules | Model Antibody,点击Model Antibody Framework,打开Model Antibody Framework对话框。 点击Light Chain Sequence右边的栅格,下拉列表中选取MA5_L:MA5_L。 点击Heavy Chain Sequence右边的栅格,下拉列表中选取MA5_H:MA5_H。 点击Interface Template右边的栅格,下拉列表中选取Overall Framework Hits:2XWT_BA_FV。 将Number of Models设为3。其它参数选择默认。 图2 点击Run运行作业,等待作业完成(图3)。 待作业完成后,点击View Results查看结果,一个是名为MA5_L_MA5_H的序列窗口,另一个是名为MA5_L_MA5_H的分子窗口,包含了表面模板和三个模型结构(图4)。 图4 2 模型的PDF值或者DOPE值分析 建模过程中,DS MODELER首先会提取模板(template)的几何特性,然后使用PDF(probability density function)函数来定义蛋白结构中诸如键长、键角、二面角等几何特性。接着它会对PDF函数施加一定的约束条件,并以此来构建target的3D结构。所以PDF的函数值可以直接反应所构建模型的好坏。一般,模型的PDF Total Energy越低,表明该模型在同源约束条件下优化的越好;模型同限定的同源约束条件偏差越小,该模型的可信度越大。然而,如果构建的模型其PDF Total Energy相似,则可以利用基于原子统计势能的DOPE score作为衡量模型质量的依据。DOPE是一个基于原子统计势能的程序,主要用于模型评估。它的分数可以认为是衡量同一分子不同构象可信度的标准,能够帮助选择预测结构的最优模型。分数越低,模型质量越可靠。三个模型的结构按照PDF Total Energy,PDF Physical Energy和DOPE Score升序排列。 在MA5_L_MA5_H分子窗口的表格视图(Table View)中,点击Molecule标签栏。 可以查看每个模型的PDF Total Energy,PDF Physical Energy,DOPE Score。比较每个模型之间的结构区别和与模板之间的结构区别。 在系统视图(Hierarchy View)中,展开MA5_L_MA5_H.M0002 | Modeler Groups。 在该组下可以看到,模型序列中同模板序列一致的(Identical)或者相似的(Similarity)以及没有比对上的(No Match)的氨基酸残基分别归于不同的组。 关闭Model Antibody Framework Report页面,Overall Framework Hits 分子窗口和序列窗口。 构建抗体LOOPS区结构 抗体结合抗原的选择性是由抗体可变区的CDR LOOP决定的。每个可变区都有3个超可变LOOP,L1,L2,L3,H1,H2,H3,它们形成了抗原结合位点,在本教程中我们将使用Model Antibody Loops protocol来识别模板,并使用这些模板来构建抗体中的CDR区域。DS可以基于序列识别出抗体中的高可变区,即互补决定区(CDR),并采用BLAST相似性搜索从抗体结构域以及CDR库中为每个CDR区搜索可能的loop模板,所搜寻到的模板将同相应的CDR区进行叠合。 点击激活MA5_L_MA5_H分子窗口。 在工具浏览器(Tools Explorer)中,展开Macromolecules | Model Antibody,点击Model Antibody Loops,打开Model Antibody Loops对话框。 确保Input Protein Molecules为MA5_L_MA5_H: MA5_L_MA5_H.M0002。 设置Maximum Templates Per Loop为3。 将Build Models设为True,并展开该组,将Number of Models设为1。 其它选择默认。(图5) 点击Run运行任务。选择background使之在后台运行。 图5 Model Antibody Loops protocol使用隐马尔科夫模型识别抗体中的可变区和相应CDR区,并运行一个相似性搜索,搜索预编译的抗体数据库,针对每个CDR LOOP寻找三个最匹配的模板,其中包括一个序列叠合的过程,叠合过程中将每个LOOP模板叠合到之前的抗体结构的CDR区,过程中使用MODELER基于命中的模板产生模型结构。待作业完成后,查看作业结果,双击任务栏的任务名称,打开任务报告。 该报告中包含了每个CDR区域LOOP残基,识别的模板,和模板LOOP打分,由于抗体结构有多条链,每条链的LOOP都列出在表中,同时,表单中还包括识别并使用的模板的分辨率,相似性和一致性,还有物种的来源等。 在报告页面中点击View Results链接。 同时自动打开两个新的窗口,一个是名为MA5_L_MA5_H_M0002的序列窗口,包含了两个模型序列(loop优化前和优化后)同loop模板序列的比对结果(图6),另一个是名为MA5_L_MA5_H_M0002的分子窗口,包含了loop模板结构和两个模型结构的叠合结果(图6)。 这两个窗口可以并排显示,并一一对应。 在分子窗口的系统视图中展开MA5_L_MA5_H_M0001_M.M00012|CDR Loops文件夹。 可以看到模型中重链和轻链各三个CDR区。 点击选中CDR Loops。 可以看到在分子窗口和序列窗口都分别由loop结构和序列被选中。 注:同一个模板结构可以用于构建多个CDR Loop结构,但是显示的时候则仍分开显示。 图6 在分子窗口的表格视图(Table View)中点击Molecule标签栏。 在报告页面滚动滑轮,可以查看到loop优化前后模型的PDF Total Energy,PDF Physical Energy,DOPE Score,以及每个模板结构的打分及同目标序列中相应CDR区序列的一致性及相似性等诸多信息。 鼠标右键点击序列窗口中的标尺,选择Residue ID,将序列的残基号显示在序列窗口中。 模型评估 等模型构建完成后,一般需要对其进行评估。DS为用户提供了多种模型评估方式。主要包括:Ramachandran plot 和Profile-3D。具体操作参照Model_Enzyme教程。最终我们发现第一个模型是最好的。 将构建的模型结构与X射线晶体结构进行叠合 接下来,我们将使用蛋白叠合工具比较构建的最终的抗体模型和使用X射线获得的该抗体的晶体结构(PDB ID:4M6M)。 在文件浏览器(Files Explorer)中,双击打开Samples | Tutorials | Protein Modeling | Ab05.pdb。将之前构建好的第一个抗体模型复制并黏贴到Ab05的分子窗口中,选中模型,点击菜单栏中Display Style右边的三角符号,选择第一种分子显示方式。 点击分子窗口空白处,取消模型选择。 点击Macromolecules | Superimpose Proteins 工具栏中Sequence Alignment右边的Create… 点击之后,程序打开了一个包含两个结构的序列窗口和序列叠合流程设置窗口如下图: 使用窗口里面的默认设置,点击Run 计算完成后显示如下窗口:序列的相似性和一致性都达到99.6% 点击OK关闭该对话框。点击Ab05分子窗口,点击Macromolecules | Superimpose Proteins工具面板中的 Superimpose, 之后点击Show Report结果如下图所示 在窗口中抗体模型和晶体结构叠合在一起,227个残基的RMSD值为0.9 关闭右边的报告页面窗口 从上图叠合之后的图中可以看到叠合之后结构中的VL_LAMBDA_CDR3 和 VH_CDR3区域结构区别较大。 回到Ab05序列窗口。从菜单栏中选择Edit | Select…. 设置Residue Property: Secondary structure 为 Sheet 点击OK如下图所示 鼠标右键点击序列窗口选择Extend Aligned Selection 点击Ab05分子窗口使之处于活跃状态。 从菜单中选择Structure | RMSD | Biopolymer Structures…. 设置Referencemolecule为Ab05 选择我们构建的模型Calculate RMSD for molecules 选择Selected residues选项 选择C-Alpha,取消选择Amino acids下面的Main-chain,点击OK如下图 一个RMSD报告打开了,这个报告显示了结构中形成折叠的残基较低的Cα 原子的 RMSD(0.621),同时表明了结构的准确性。 激活Ab05分子窗口,打开层次视图,点击模型分子中的CDR LOOPS基团,选择VH_CDR3基团,接下来使用同样的方法计算LOOP的基于Cα 原子的RMSD为0.522如下图。 抗体全长3D结构的预测 载入序列 在文件浏览器(Files Explorer)中,双击打开LC.bmsl,HC.bmsl两个个序列文件。 上述两个序列依次分别为全长抗体的轻链(L)序列和重链(H)序列。 构建目标序列的3D模型 在工具浏览器(Tools Explorer)中,展开Macromolecules | Model Antibody,点击Model Full Length Antibody,打开Model Full Length Antibody对话框。 点击Light Chain Sequence右边的栅格,下拉列表中选取LC:Light。 点击Heavy Chain Sequence右边的栅格,下拉列表中选取HC:Heavy。 点击Template Source右边的栅格,下拉列表中选取1igv。 点击Copy Ligands右边的栅格,下拉列表中选取True。 将Number of Models设为1。 点击Optimization Level右边的栅格,下拉列表中选取Medium。(图7) 图7 点击Run运行作业,等待作业完成。 待作业完成后,点击View Results查看结果。 同时自动打开两个新的窗口,一个是名为Light_Heavy的序列窗口,包含了模型序列同模板序列的比对结果,另一个是名为Light_Heavy的分子窗口,包含了模板结构和一个模型结构。这两个窗口可以并排显示,并一一对应。(图8) 注:同样根据体系仔细检查序列比对结果,如有必要,可以手动进行细微调整,然后基于新的比对结果采用Build Homology Models流程重新进行模型的构建。 图8 在Light_Heavy分子窗口的系统视图(Hierarchy View)中,展开Protein Groups文件夹,点击Disulfide Residues可以显示抗体模型中形成二硫键的氨基酸残基。(图9) 图9 后续操作同抗体Framework区模型构建步骤类似,不再详述。 #生物/化学/分子仿真分析 1.本网站中的文章由用户上传发布,版权归原作者和著作权人所有。该文观点仅代表作者本人,软服之家系信息发布平台,软服之家仅提供信息存储空间服务。2.本网站用户上传的资讯内容及文章,尽可能注明出处,但不排除来源不明的情况。如果您觉得侵犯了您的权益,请通知我们更正或删除。若未声明,则视为默许。由此而导致的任何法律争议和后果,本站不承担任何责任。
BIOVIA Discovery Studio 生物/化学/分子仿真分析 东方科软(北京)科技有限公司 BIOVIA Discovery Studio(简称DS),是一款面向生命科学领域的综合分子建模和模拟软件,基于Windows/Linux系统和个人电脑、面... 询价
东方科软(北京)科技有限公司 认证商家 东方科软成立于2016年10月,总部设在北京,主要服务材料科学与生命科学两大领域的用户,为其提供模拟仿真软件、技术咨询、技术培训及技术支持服务。... 打电话 在线咨询 询价
【Discovery Studio文献解读】Cra酶的半理性设计提高丁二酸盐合成 观点分析 东方科软 2026-09-20 摘要 本文聚焦大肠杆菌中全局转录因子 Cra(分解代谢阻遏物 / 激活物)与效应物 FBP(1,6 - 二磷酸果糖)的亲和力对琥珀酸生产的影响,通过半理性设计、分子生物学与发酵工程结合的方法,首次证实两者的正相关性并阐明其分子机制。琥珀酸是...
【Discovery Studio文献解读】水杨酸对多酚氧化酶(PPO)抑制机制的研究 观点分析 东方科软 2026-09-17 摘要 多酚氧化酶(PPO)广泛存在于动植物和微生物中,可催化单酚羟化生成邻二酚,进而氧化为邻醌,邻醌易与蛋白质、氨基酸反应生成黑色素,导致果蔬等园艺作物采摘后酶促褐变,严重影响其感官和营养品质,是采后损失的主要原因。化学抑制是控制褐变的实用...
【Discovery Studio文献解读】基于分子对接的VLP18-Fab抗体表位鉴定 软件教程 东方科软 2026-09-14 摘要 宫颈癌是全球女性第四大致死癌症,且发病率和死亡率持续上升。根据GLOBOCAN 数据:2008 年全球新发病例 52.9 万,死亡 27.5 万;2020 年新发病例增至 60.4 万,死亡 34.2 万,在多个国家已位居女性癌症发病...
【Discovery Studio文献解读】GD2抗体3F8抗体人源化设计 观点分析 东方科软 2026-09-07 摘要 GD2 是 b 系列神经节苷脂的一员,正常情况下主要在胎儿发育阶段表达;成年后表达高度受限,仅在中枢神经系统中少量存在,外周神经和皮肤黑素细胞中表达水平极低,这一特性降低了靶向治疗的正常组织毒性风险。GD2 在多种儿童和成人肿瘤细胞表...
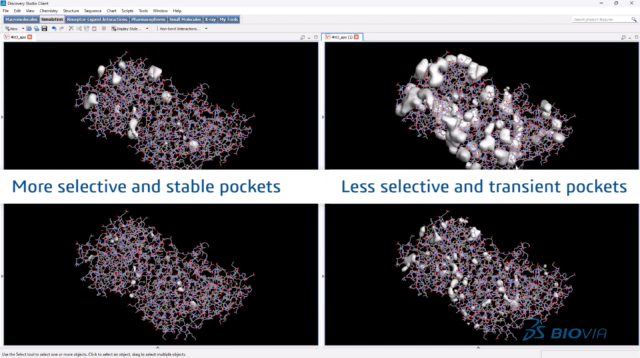
BIOVIA Discovery Studio 功能模块 功能模块 2026-08-29 BIOVIA Discovery Studio 提供分子建模与模拟、蛋白质结构、药效团与对接、自由能计算、生物治疗药物开发等模块,覆盖从靶标识别到先导化合物优化的药物发现流程。
BIOVIA Discovery Studio 2026 发布 新版发布 2025-11-30 BIOVIA Discovery Studio 2026 于 2025 年 11 月发布,引入基于 OpenMM 的 GPU 加速分子动力学、基于 OpenFE 的相对自由能计算等新协议,并加强蛋白质口袋与轨迹分析能力。
文献解读 | Discovery Studio应用案例:靶向PRRSV抗体5F2的表位鉴定 解决方案 东方科软 2026-08-10 摘要 猪繁殖与呼吸综合征病毒(PRRSV)是全球养猪业最具破坏性的病原体之一,其对产业的冲击和自身的生物学特性构成了基础挑战。PRRSV 可导致猪群繁殖障碍(流产、死胎)、呼吸道疾病(仔猪呼吸困难、死亡率升高),仅美国每年因该病造成的损失就...
蛋白结合物设计,正在进入“一体化”新阶段 观点分析 北京泰科博思 2026-08-05 蛋白结合物设计,正在进入“一体化”新阶段 在生物医药研发中,蛋白结合物设计一直是一个高价值、也高难度的方向。 无论是候选分子的筛选、功能位点的识别,还是后续结构优化与成药性评估,研发团队往往都要在多个工具、多个流程之间反复切换。流程越复杂,...
BIOVIA Discovery Studio:功能特性、技术优势与应用解析 软件介绍 2026-08-05 BIOVIA Discovery Studio产品概述 BIOVIA Discovery Studio是药物设计与模拟软件。提供蛋白质建模、分子对接、药效团搜索和ADME预测,帮助制药企业加速药物发现过程。作为3DEXPERIENCE平台的...
BIOVIA Discovery Studio:达索系统科学创新与实验室信息化解决方案 软件介绍 2026-08-05 BIOVIA Discovery Studio产品概述 BIOVIA Discovery Studio是达索系统(Dassault Systèmes)BIOVIA品牌旗下的科学解决方案,致力于帮助科研人员发现、设计、开发和交付创新的药物、材...
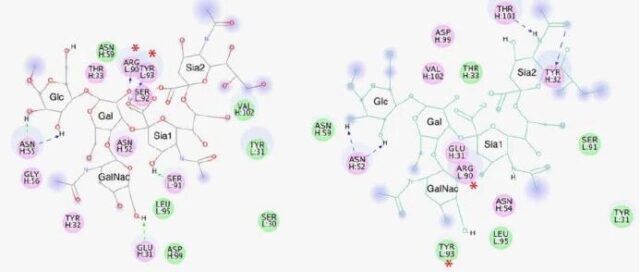
【Discovery Studio文献解读】靶向GD2 与T细胞CD3分子的双特异性抗体结构优化 观点分析 东方科软 2026-06-10 文献解读 神经母细胞瘤占儿童癌症死亡总数的 15%,低、中危患者治愈率已显著提升,但 18 个月以上确诊的 4 期高危患者预后极差。肿瘤细胞可通过多种机制逃避经典 T 细胞免疫,而 T 细胞作为最有效的肿瘤杀伤效应细胞,因缺乏 Fc 受体,...
不只是分子建模:达索系统BIOVIA到底在下一盘什么棋? 软件介绍 2026-04-28 提到达索系统,大家通常想到的是它在航空、汽车、工业设备等高端制造领域的解决方案。 其实在它的旗下,还有一个专门面向科学领域的品牌——BIOVIA。 熟悉BIOVIA的人,可能会先想到分子模拟与量子化学:Materials Studio、Di...
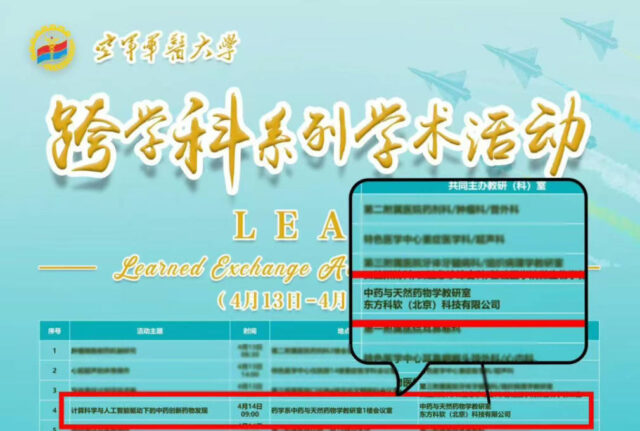
东方科软走进空军军医大学,共话 AI 与计算科学赋能新药研发 新闻资讯 东方科软 2026-04-15 4月14日,空军军医大学举办跨学科系列学术会议,东方科软参与交流,围绕“计算科学与人工智能驱动下的中药创新药物发现”展开专题分享,助力产学研深度融合与科研能力提升。 会议聚焦新一代技术赋能科研创新,介绍了Discovery Studio在药...
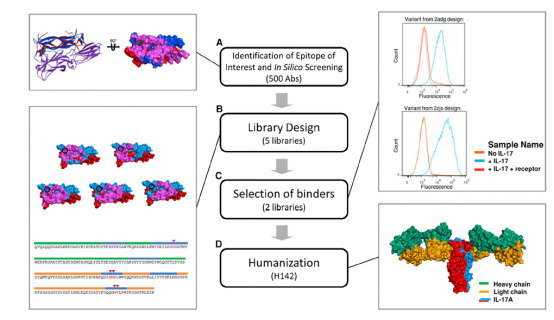
【Discovery Studio文献解读】IL-17A抗体的从头设计 解决方案 东方科软 2026-04-07 01 文献解读 蛋白质设计的终极目标是赋予蛋白质新的生物活性。本研究提出一种计算设计功能性抗体的方法,该方法以功能表位为核心,将大规模统计分析与多结构模型相结合,并通过机器学习预测抗原与抗体之间的特异性残基-残基接触。研究团队应用此方法设计...
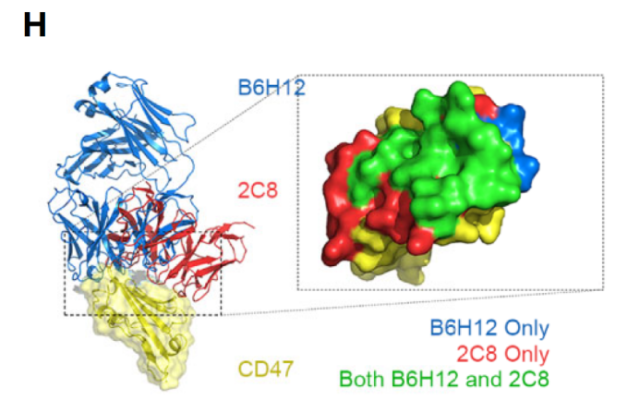
【Discovery Studio文献解读】新型抗CD47阻断抗体2C8结合表位预测 观点分析 东方科软 2026-03-27 01 文献解读 本文开发并评估了一种新型抗 CD47 阻断抗体 2C8:该抗体为小鼠 IgG1 亚型,对 CD47 具有高亲和力(解离常数 Kd=0.2991×10⁻⁹M),可通过阻断 CD47 与巨噬细胞表面 SIRPa 的相互作用,在体...
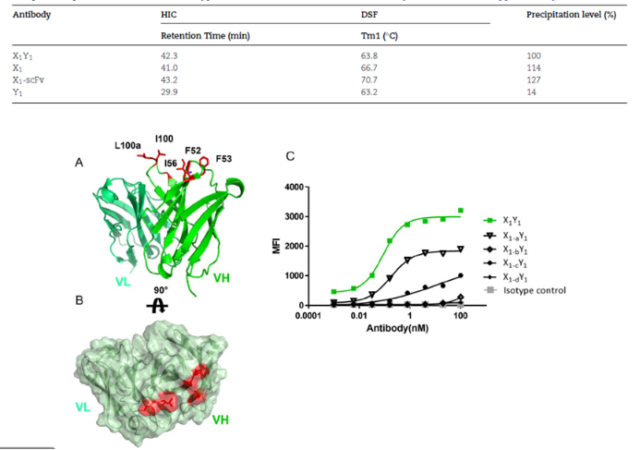
【Discovery Studio文献解读】双特异性抗体发现阶段的可开发性评估与优化 观点分析 东方科软 2026-03-11 01 文献解读 双特异性抗体因能靶向两个抗原或同一抗原的两个表位,在生物制药领域极具潜力,但复杂的分子结构使其在可制造性(大规模生产、储存等相关特性)方面面临诸多挑战,聚集是常见问题,可能影响生产、生物活性并增加免疫原性风险。一款 scFv...
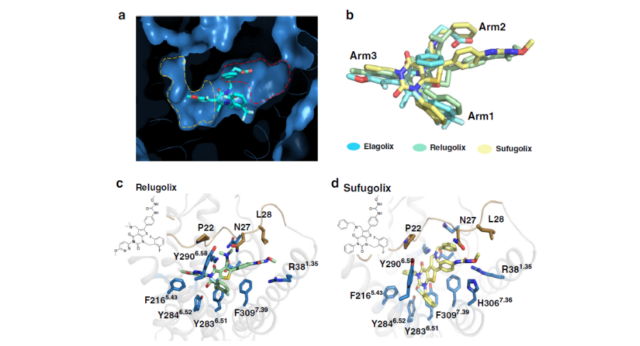
【Discovery Studio文献解读】GnRH1R与小分子拮抗剂elagolix结合模式分析 观点分析 东方科软 2026-03-02 01 文献解读 GnRH1R 是视紫红质类 G 蛋白偶联受体(GPCR),调控下丘脑 - 垂体 - 性腺(HPG)轴,是不孕、子宫内膜异位症、前列腺癌等疾病的重要药物靶点。已有 elagolix、relugolix 等小分子拮抗剂获批或进入...
【Discovery Studio文献解读】非催化抗体转化催化抗体的作用机制研究 观点分析 东方科软 2026-01-04 01 文献解读 非催化抗体(Non-catalytic Antibody),指天然状态下仅具备抗原结合能力,但无酶促催化活性的常规抗体。其核心功能是通过可变区(尤其是 CDR 区域)与抗原特异性结合,参与免疫识别,但无法水解或转化底物(如肽...
【Discovery Studio文献解读】Fab影响ADCC效应的结构分析 观点分析 东方科软 2025-12-24 01 文献解读 IgG 通过与 FcγRIIIa 结合触发抗体依赖的细胞毒性(ADCC),是免疫治疗的核心机制之一。传统观点认为,二者相互作用仅依赖 IgG 的 Fc 片段,因此研究多集中于 Fc 域糖基化修饰(如去岩藻糖增强 ADCC)或...
【Discovery Studio文献解读】抗体成药性表征中的电荷变体分析分子模拟方法 解决方案 东方科软 2025-12-16 01 文献解读 摘要: 聚焦治疗性单克隆抗体(mAb-1)开发过程中的电荷变体异常问题,通过多维度实验与分子模拟技术,揭示了重链互补决定区 3(HC-CDR3)的 pH 依赖性构象变化及其与电荷状态的关联,为生物制药研发中的蛋白表征提供了关...